공지사항 중복 발송과 유실 문제 해결
문제
- 운영자가 공지를 등록하면 푸시 수신에 동의한 기기 1만 대에 외부 푸시 업체 API로 발송
- 업체 API는 기기마다 한 번씩 호출하며, 만료된 토큰에는 410, 업체 쪽 장애에는 503을 응답
- 처음에는 발송 요청을 받은 스레드가 기기 목록을 돌며 업체 API를 순서대로 호출
for (PushDevice device : deviceRepository.findAllEnabled()) {
    try {
        providerClient.send(device.token(), title, body);
        sent++;
    } catch (RuntimeException e) {
        // 실패는 로그만 남기고 다음 기기로 넘어감
        failed++;
    }
}
요청 하나가 발송 전체를 끌고 감
- 1만 건을 순서대로 보내 발송이 끝나기까지 약 5분 16초 소요
- 게이트웨이 타임아웃 60초가 지나면 운영자는 실패 응답을 받지만 서버의 요청 스레드는 연결이 끊긴 것을 모른 채 끝까지 발송
- 운영자는 발송이 실패했는지, 어디까지 나갔는지 알 수 없음
재요청이 중복 발송으로 이어짐
- 응답을 받지 못한 운영자가 다시 누르면 발송 루프가 하나 더 생겨 같은 공지를 처음부터 다시 보냄
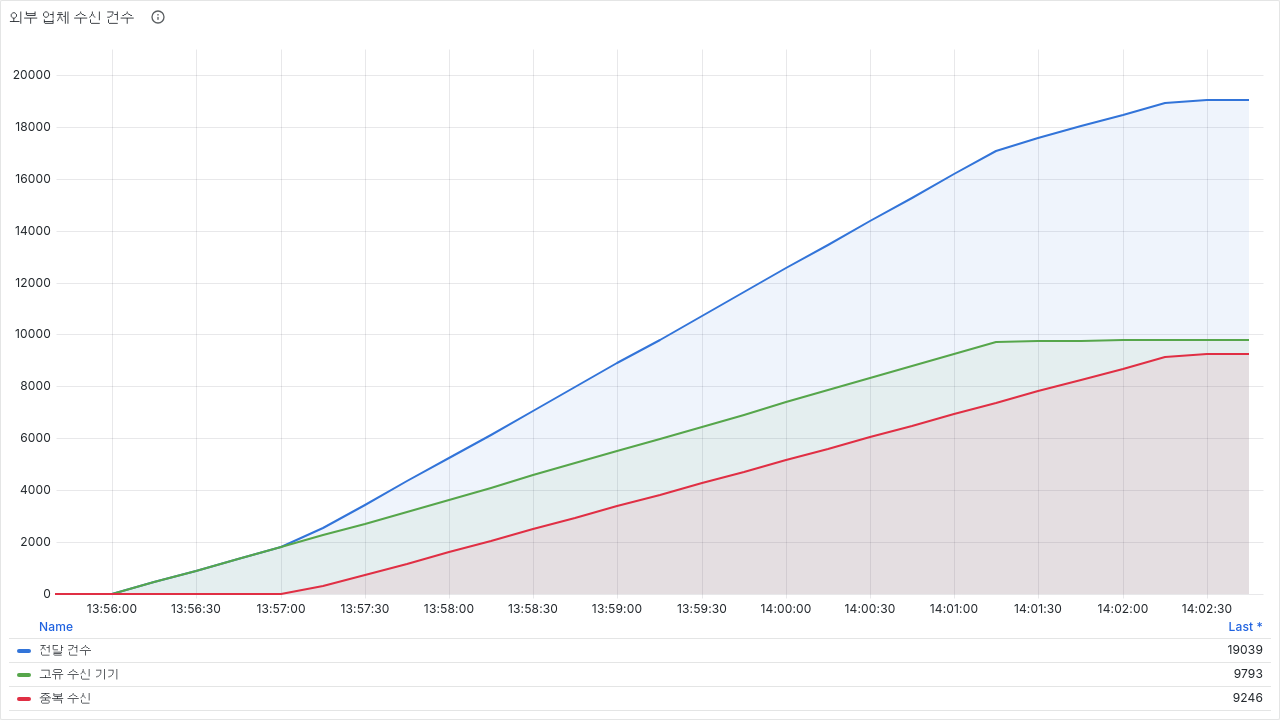
- 두 번의 요청으로 업체가 전달한 19,039건 중 9,246건은 이미 공지를 받은 기기에 다시 간 중복
실패한 발송은 버려짐
- 일시적인 503도 다시 보내지 않아 두 번의 발송에서 일시 실패 561건이 로그로만 남음
- 같은 공지를 두 번 보냈는데도 1만 대 중 207대는 끝내 공지를 받지 못함
해결 전략
- 접수와 처리 분리
- 발송 API는 접수 내용을 DB에 저장하고 바로 202로 응답
- Dispatcher가 접수된 발송을 기기 단위 메시지로 나눠 Kafka로 넘기고 Consumer 6개가 partition별로 병렬 발송
- 두 단계 멱등성
- 접수: 클라이언트가 보낸
Idempotency-Key를 unique key로 저장해 같은 요청에는 같은 발송을 응답 - 발송: 공지와 기기 한 쌍인 발송 단위(
push_delivery)를 조건부 UPDATE로 선점해 한 번만 발송
- 접수: 클라이언트가 보낸
- 실패 격리
- 5xx와 타임아웃은 재시도 토픽에서 2초, 6초, 18초 뒤 다시 발송
- 4xx로 실패했거나 재시도를 모두 쓴 메시지는 DLT에 격리하고 원래 토픽은 다음 메시지를 계속 처리
기술 선택 이유
접수와 처리 분리
-
@Async로 발송만 비동기 실행 - 제외- 응답은 빨라지지만 발송 진행 상태가 메모리에만 있어, 서버가 재시작되면 어디까지 보냈는지 알 수 없음
- 재요청을 막는 장치가 없어 중복 발송 문제는 그대로 남음
-
접수 API에서 바로 Kafka 발행 - 제외
- DB 저장과 Kafka 발행을 한 트랜잭션으로 묶을 수 없음
- 한쪽만 성공하면 접수된 발송이 나가지 않거나 기록 없는 발송이 나감
-
DB 접수 후 스케줄러 분배 - 채택
- 접수 API는 DB 한 곳에만 써서 이중 쓰기 문제가 생기지 않음
- 분배 도중 인스턴스가 죽으면 1분 넘게 갱신되지 않은 발송을 처음부터 다시 분배
- 다시 분배해도 이미 만든 발송 단위는
INSERT IGNORE가, 이미 보낸 메시지는 선점 UPDATE가 걸러냄
발송 멱등성
-
Redis
SETNX로 발송 기록 - 제외- 중복 판단은 빠르지만 발송 현황(보낸 건, 실패한 건, 남은 건)은 DB에 따로 둬야 해서 두 저장소의 상태가 어긋날 수 있음
-
push_delivery조건부 UPDATE - 채택PENDING인 행만SENDING으로 바꾸고 affected rows가 1인 처리만 업체를 호출- 같은 테이블로 발송 현황 조회까지 처리
실패한 메시지 처리
- 같은 자리에서 성공할 때까지 재시도 - 제외
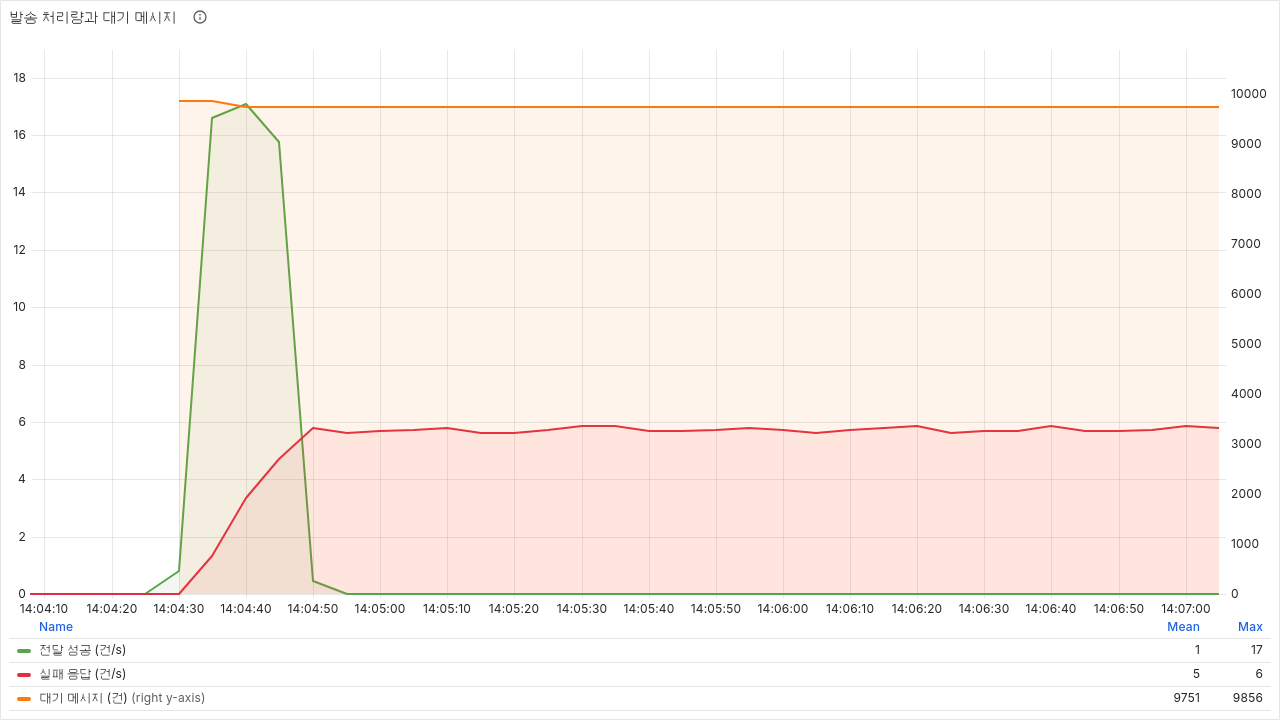
- 메시지를 잃지 않으려고 실패하면 1초 간격으로 무한 재시도하게 했더니, 만료 토큰과 장애 토큰에서 partition 6개가 모두 멈춤
- 256건을 보낸 뒤 전달 성공이 0으로 떨어지고, 같은 메시지만 초당 약 6건씩 다시 보내는 동안 대기 메시지 약 9,750건이 그대로 남음
- 재시도 토픽과 DLT - 채택
- 실패한 메시지를 재시도 토픽으로 넘기면 원래 partition은 바로 다음 메시지를 처리
- 재시도 간격을 늘려 가며 업체의 짧은 장애는 넘기고, 26초 넘게 이어지는 실패는 DLT에 원본 그대로 보존
- 4xx는 다시 보내도 결과가 같아 재시도 없이 DLT로 보냄
구현
접수
public AcceptResult accept(String idempotencyKey, String title, String body) {
    var existing = broadcastRepository.findByIdempotencyKey(idempotencyKey);
    if (existing.isPresent()) {
        return AcceptResult.existing(verifySameRequest(existing.get(), title, body));
    }
    try {
        PushBroadcast saved = broadcastRepository.saveAndFlush(
                PushBroadcast.accept(idempotencyKey, title, body, LocalDateTime.now())
        );
        return AcceptResult.created(saved);
    } catch (DataIntegrityViolationException e) {
        // 같은 키의 요청이 동시에 들어와 다른 요청이 먼저 저장. unique key가 한 건만 남김
        PushBroadcast winner = broadcastRepository.findByIdempotencyKey(idempotencyKey).orElseThrow(() -> e);
        return AcceptResult.existing(verifySameRequest(winner, title, body));
    }
}
- 새로 접수하면 202, 같은 키로 이미 접수된 발송이면 200으로 같은 발송 번호를 응답
- 같은 키로 내용이 다른 요청이 오면 첫 접수를 돌려주지 않고 409로 거절
발송 단위 선점
UPDATE push_delivery
SET status = 'SENDING', attempt_count = attempt_count + 1, updated_at = NOW(6)
WHERE broadcast_id = ? AND device_id = ?
  AND (status = 'PENDING'
       OR (status = 'SENDING' AND updated_at < NOW(6) - INTERVAL ? SECOND))
- affected rows가 0이면 현재 상태를 보고 나눠 처리
SENT,FAILED: 이미 끝난 발송이 다시 들어온 것이라 호출하지 않고 넘어감SENDING: 다른 처리가 보내는 중. 그 처리가 업체 호출 도중 죽었을 수 있어 버리지 않고 재시도 토픽으로 넘김
SENDING이 lease 10초보다 오래 남아 있으면 처리하던 인스턴스가 죽은 것으로 보고 다시 선점- 업체 호출의 read timeout이 3초라 정상 처리가 10초를 넘기지 않음
재시도와 DLT
@RetryableTopic(
        attempts = "${push.send.retry.attempts}",         // 4
        backoff = @Backoff(
                delayExpression = "${push.send.retry.delay-ms}",        // 2초
                multiplierExpression = "${push.send.retry.multiplier}"  // 3배
        ),
        exclude = PermanentPushFailureException.class,   // 4xx는 재시도 없이 DLT
        dltTopicSuffix = "-dlt"
        // 토픽 이름 규칙과 partition 수 설정은 생략
)
@KafkaListener(topics = PushTopics.SEND, concurrency = "${push.send.concurrency}")
public void send(String payload) {
- 업체 5xx와 타임아웃: 선점을
PENDING으로 되돌리고 예외를 던져 재시도 토픽으로 보냄 - 업체 4xx:
FAILED로 기록하고 재시도 없이 DLT로 보냄 - DLT 핸들러는 원본 메시지를 보존한 채 남은 발송 단위를
FAILED로 마무리
검증
| 항목 | 설정 |
|---|---|
| 수신 기기 | 10,000대 |
| 외부 업체 대역 | 응답 30±10ms, 정상 토큰의 3%에 일시 503 |
| 실패 토큰 | 만료 토큰 100대(410), 계속 503을 받는 토큰 100대 |
| Push Service | 1대, Consumer 6개 (partition 6개) |
| 운영자 행동 | 같은 발송을 두 번 요청 (동기 발송은 60초 타임아웃 5초 뒤 재요청, 변경 후는 같은 키로 연속 요청) |
- 외부 업체는 응답 지연과 실패를 재현하고 같은 기기가 같은 공지를 다시 받았는지 세는 대역 서버로 대신함
- 발송 도중 업체 전달이 3,000건을 넘은 시점에 Push Service를 SIGKILL로 강제 종료하고 5초 뒤 재시작
처리량
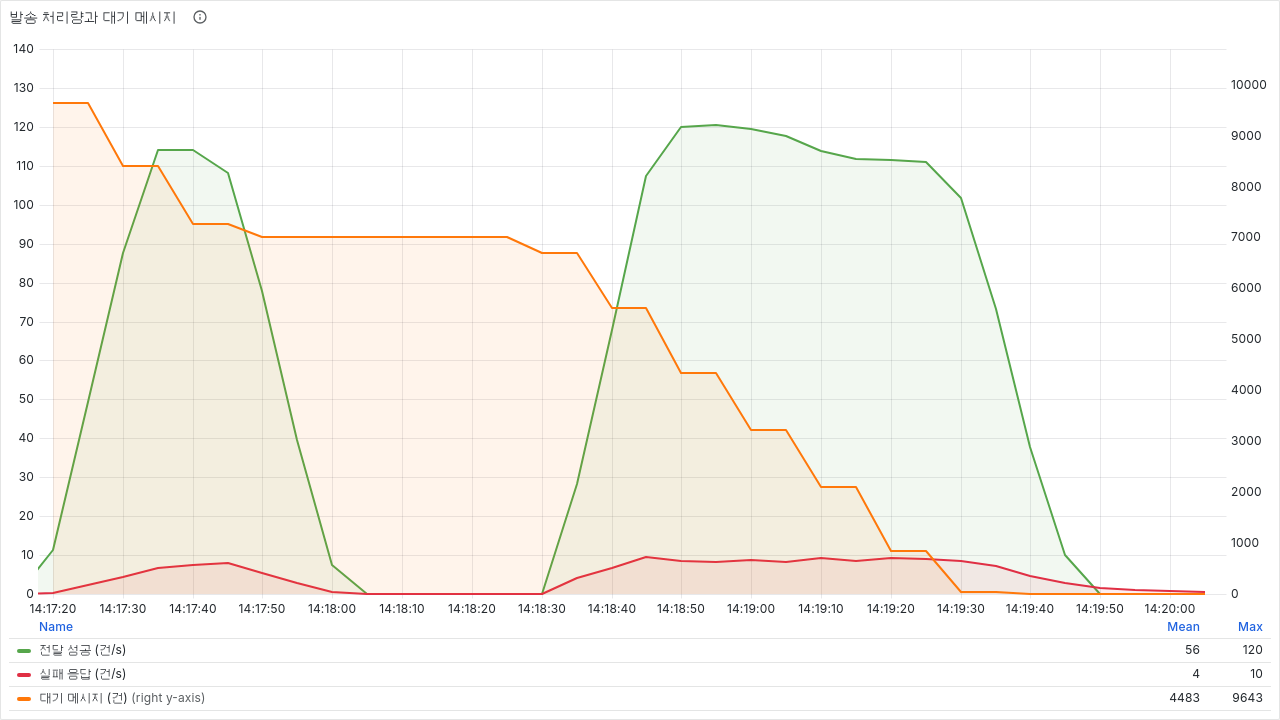
- 접수 요청은 107ms에 202 응답, 같은 키로 보낸 두 번째 요청은 6ms에 같은 발송을 응답
- 강제 종료 뒤 약 45초 동안 발송이 멈춤. 죽은 Consumer가 세션 만료(기본 45초)로 그룹에서 빠질 때까지 partition이 다시 배정되지 않았기 때문
- 재시작 뒤 초당 약 120건씩 발송해 대기 메시지 0건까지 처리. 강제 종료를 포함해 전체 발송에 약 2분 40초 소요
중복 발송
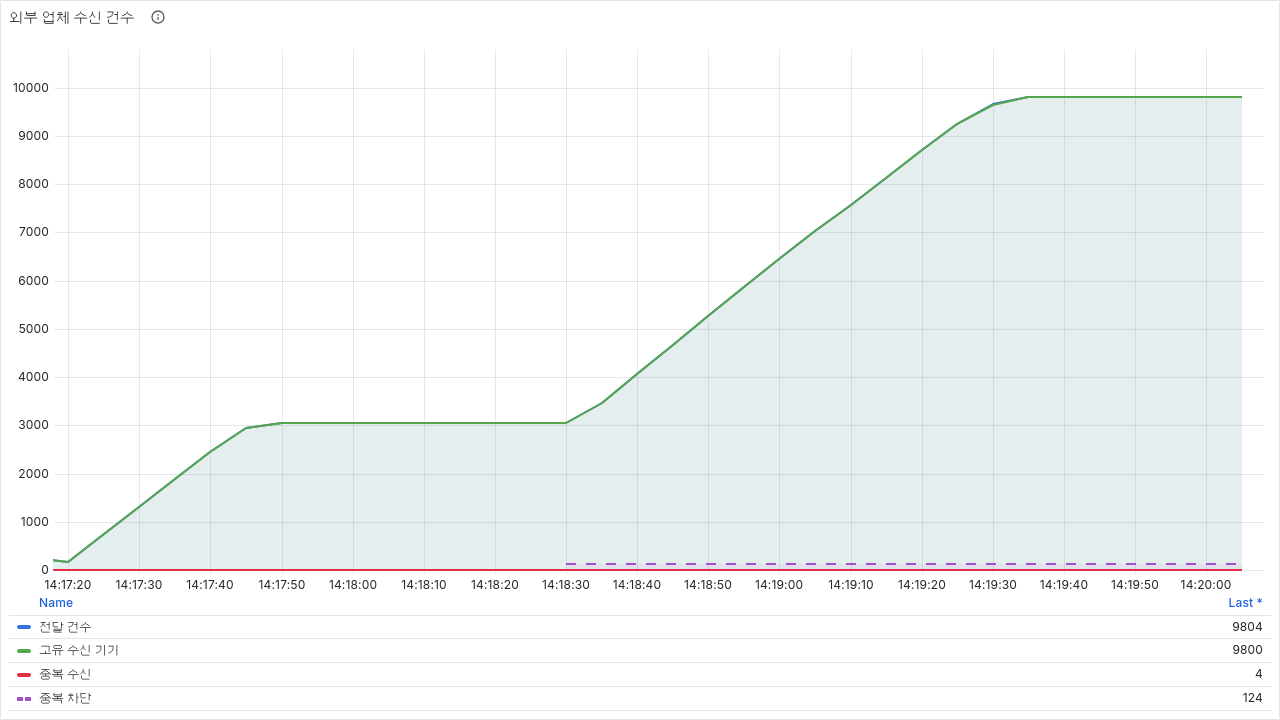
- 강제 종료로 커밋하지 못한 offset의 메시지가 다시 전달됐지만 이미 보낸 124건은 선점 UPDATE에서 걸러져 업체를 호출하지 않음
- 중복 수신 4건은 업체 호출은 성공했지만
SENT를 기록하기 전에 종료된 발송. lease가 지난 뒤 다시 선점돼 한 번 더 나감
실패 격리
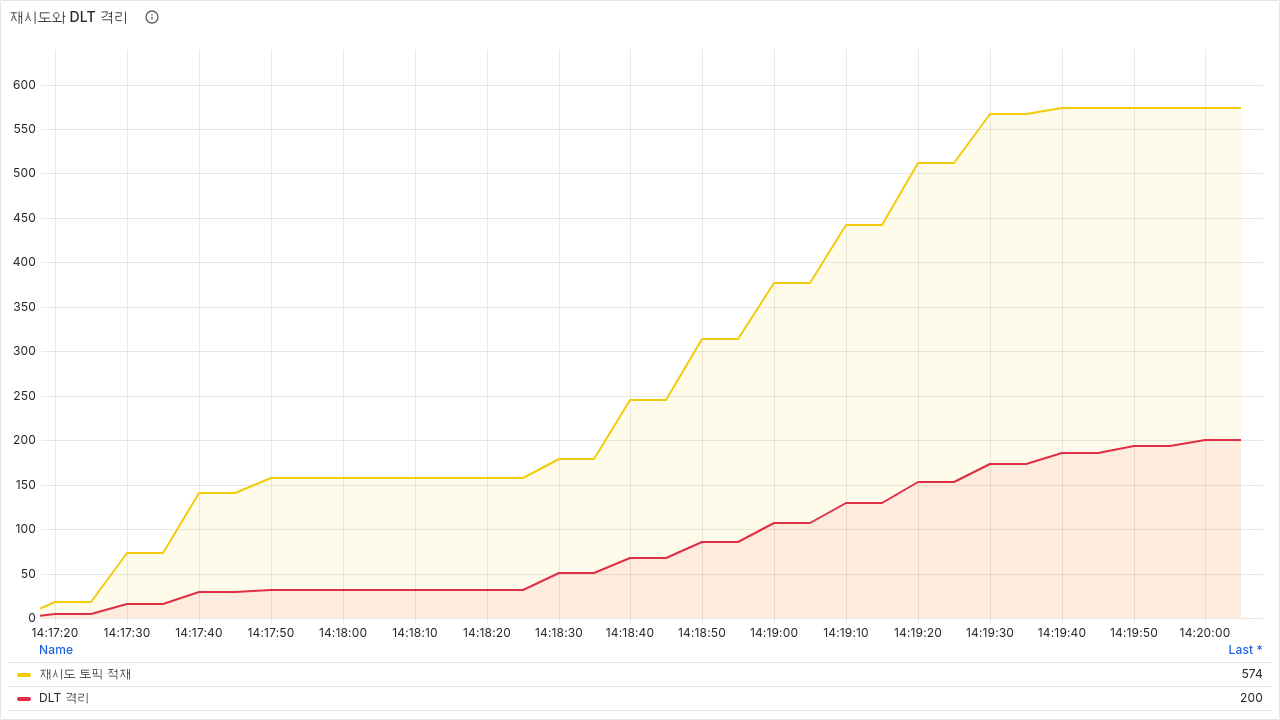
- 일시 503 응답 275건은 재시도 토픽에서 다시 보내 정상 토큰 9,800대에 모두 발송
- 만료 토큰 100건은 재시도 없이, 계속 503을 받은 100건은 네 번 시도한 뒤 DLT에 격리
- 실패한 메시지를 재시도 토픽으로 넘겨 정상 메시지의 발송은 멈추지 않음
전후 비교
| 지표 | 동기 발송 | 변경 후 |
|---|---|---|
| 발송 요청 응답 | 60초 타임아웃 (서버 발송 약 5분 16초) | 107ms (202) |
| 같은 요청 재전송 | 발송 루프 하나 더 실행 | 같은 발송 응답 (6ms) |
| 중복 수신 | 9,246건 | 4건 (강제 종료 시점) |
| 일시 실패 | 로그만 남기고 버림 (561건) | 재시도로 모두 발송 (275건) |
| 받지 못한 기기 | 207대 | 200대 (모두 DLT에 보존) |
한계
- 업체 호출 성공과
SENT기록 사이에 프로세스가 죽으면 lease가 지난 뒤 다시 발송함 (측정 4건). 업체가 멱등 키를 지원하면 발송 단위 키를 함께 보내 업체 쪽에서 걸러야 함 - DLT는 원본 보존과 실패 기록까지만 구현함. 장애 토큰이 복구된 뒤 DLT 메시지를 다시 보내는 운영 도구는 아직 없음
- Consumer가 비정상 종료되면 세션 만료(기본 45초)까지 partition이 재배정되지 않음.
session.timeout.ms를 줄이면 빨라지지만 GC 같은 일시 정지를 장애로 오판할 수 있어 기본값을 유지함 - 로컬 1만 대 기준 측정. 대상이 수십만 대로 늘면 Dispatcher 한 곳에서 분배하는 시간과
push_delivery행 수가 커져 분배 병렬화와 보관 주기 정책이 필요함