Kafka 기반 실시간 인기글 집계 구현
문제
매일 0시 스케줄러로 인기 점수를 계산하면 두 가지 문제가 생김
- 게시글과 댓글, 좋아요, 조회수를 모두 다시 읽어야 해 데이터가 늘수록 DB 조회량과 계산 시간 증가
- 자정 이후의 반응은 다음 실행까지 반영되지 않아 최대 24시간 지연
해결 전략
- 각 서비스가 게시글과 댓글, 좋아요, 조회수 변경을 Kafka 이벤트로 발행
- Hot Article Service가 이벤트를 구독해 게시글별 최신 수치를 Redis에 갱신
- 좋아요 3점, 댓글 2점, 조회수 1점으로 점수를 매겨 당일 Sorted Set에 Top 10 유지
기술 선택 이유
-
Domain Service의 인기글 API 직접 호출 - 제외
- Hot Article Service의 장애나 지연이 게시글과 댓글, 좋아요, 조회수의 쓰기 요청까지 전파
-
스케줄러로 전체 데이터 재계산 - 제외
- 전체 데이터를 반복 조회해야 하고 집계 주기 사이의 변화를 바로 반영하기 어려움
-
Kafka로 변경 사항 전달 - 채택
- 발행 측과 집계 측이 분리돼 인기글 쪽 장애나 지연이 쓰기 요청으로 번지지 않음
- 장애 중 쌓인 이벤트를 복구 뒤 다시 처리 가능
구현
인기 점수 계산
private static final long LIKE_WEIGHT = 3;
private static final long COMMENT_WEIGHT = 2;
private static final long VIEW_WEIGHT = 1;

public long calculate(Long articleId) {
    return likeCountRepository.read(articleId) * LIKE_WEIGHT
            + commentCountRepository.read(articleId) * COMMENT_WEIGHT
            + viewCountRepository.read(articleId) * VIEW_WEIGHT;
}
- 서비스 API를 다시 호출하지 않도록 Redis에 게시글별 최신 댓글과 좋아요, 조회수 저장
- 좋아요 3점, 댓글 2점, 조회수 1점으로 인기 점수 계산
인기글 Top 10 저장
public void add(Long articleId, LocalDateTime time, Long score, Duration ttl) {
    redisTemplate.executePipelined((RedisCallback<?>) action -> {
        StringRedisConnection conn = (StringRedisConnection) action;
        String key = generateKey(time);
        conn.zAdd(key, score, String.valueOf(articleId));
        conn.zRemRange(key, 0, -11);
        conn.expire(key, ttl.toSeconds());
        return null;
    });
}
- 게시글 생성일별 Sorted Set에서 점수순으로 상위 10건 유지
- 점수 저장과 하위 순위 제거, TTL 설정을 Redis Pipeline 한 번으로 처리
검증
게시글을 만든 뒤 조회, 좋아요, 댓글을 발생시킨 후 인기글 API 조회
| 후보 | 입력 | 기대 점수 |
|---|---|---|
| 좋아요 게시글 | 좋아요 35개 | 105점 |
| 조회수 게시글 | 조회수 100회 | 100점 |
| 댓글 게시글 | 댓글 36개 | 72점 |
조회수는 100건마다 최신값 이벤트를 발행하는 정책에 맞춰 100회 요청
점수 반영 직후
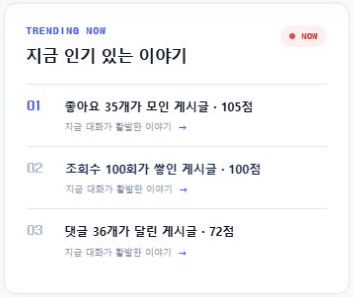
계산한 점수와 실제 인기글 순서가 105 → 100 → 72로 일치
좋아요 12개 추가 후
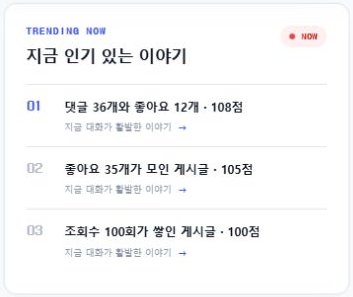
3위였던 댓글 게시글에 좋아요 12개를 추가하자 72점 → 108점으로 갱신되며 1위로 이동
한계
- 인기글 집계 대상이 생성일 기준이라 어제 쓴 글이 오늘 반응을 받아도 목록에 오르지 않음
- 조회수는 100건마다 이벤트를 발행하므로 그 사이의 변화는 다음 이벤트 전까지 점수에 반영되지 않음