SSE 연결을 유지하는 blue-green 무중단 배포
문제
- SSE로 시세를 전송하는 서비스에서 Watchtower가 새 이미지를 반영할 때 컨테이너를 바로 교체해 기존 연결도 함께 종료
- 브라우저가 자동으로 다시 연결하더라도 배포 시점에 데이터 공백과 기존 연결의 동시 재접속 발생
- Readiness를 확인하지 않아 환경변수 누락 같은 초기화 실패가 서비스 중단으로 이어질 위험
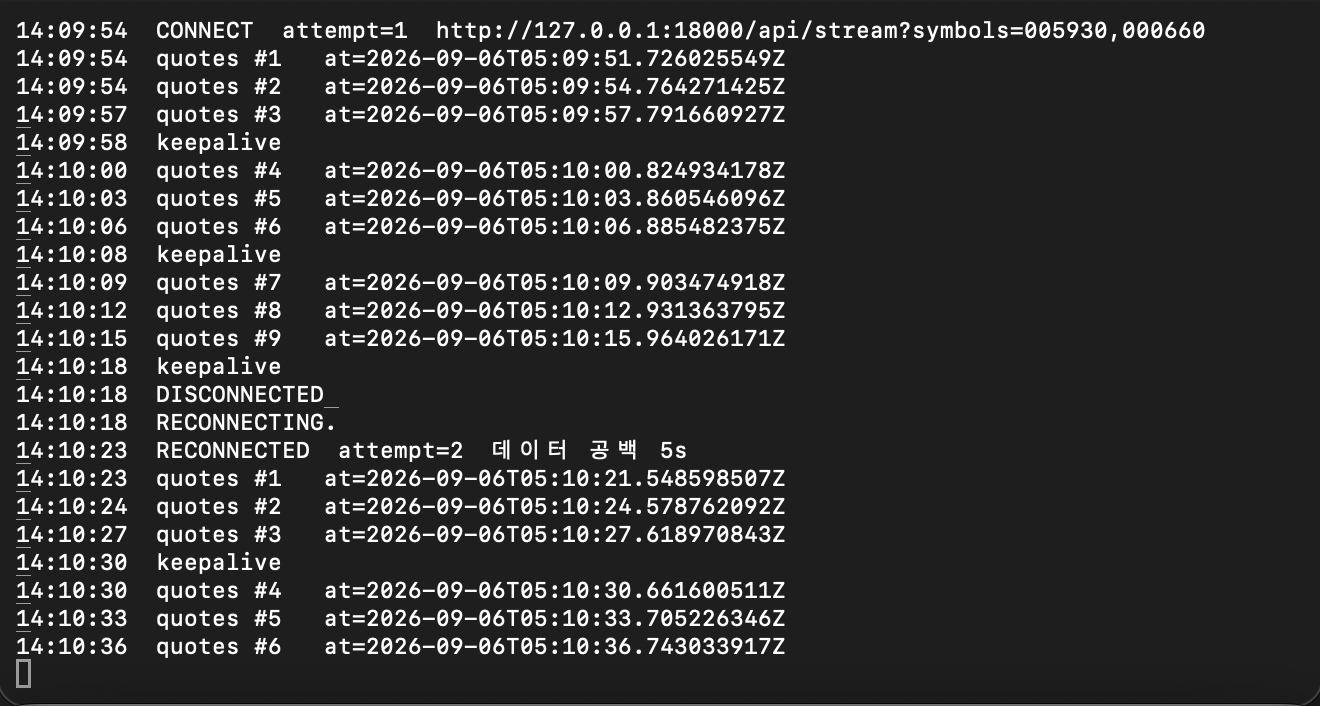
- SSE 연결 유지 상태에서
docker rm -f로 컨테이너를 교체해 같은 시각 14:10:18에 연결 종료되고 재접속까지 5초 데이터 공백
해결 전략
- 기존 버전 컨테이너를 유지한 채 다른 포트에 새 버전 컨테이너를 먼저 기동하고 Readiness 통과 후 트래픽 전환
- 기존 SSE 연결은 기존 버전 컨테이너가 계속 처리하고 최대 연결 시간 300초에 10초를 더한 310초 뒤 종료
- 전환 후 새 버전 컨테이너를 감시하다 연속 실패하면 기존 버전으로 롤백
기술 선택 이유
-
Watchtower 기반 자동 배포 - 제외
- 새 버전 검증 전에 기존 버전 컨테이너를 종료해 정상 배포에서도 SSE 연결 끊김
- 실패 이미지 자체가 원인이면 같은 이미지의 재시작만 반복
-
두 버전 상시 실행 - 제외
- 롤백 대상을 항상 유지할 수 있지만, 개인 서비스 트래픽에 비해 두 버전을 계속 띄워 두는 비용이 과함
-
배포할 때만 두 버전을 띄우는 blue-green - 채택
- 기존 연결과 신규 요청을 서로 다른 컨테이너에서 처리
- 배포 완료 후 기존 버전 컨테이너를 종료해 상시 자원 사용 방지
구현
systemd timer가 60초마다 GHCR의latestimage ID를 확인해 현재 사용하지 않는 포트에 새 버전 컨테이너 기동- 최대 90초 안에 Readiness 통과를 확인한 뒤 Nginx upstream 변경
- 전환 뒤 2초마다 새 버전 컨테이너의 Readiness를 확인하고 연속 3회 실패 시 기존 upstream으로 복구
- 실패한 image ID를 기록해 다음 실행에서 재배포를 막고 결과를 Slack으로 전송
검증
SSE 연결 유지
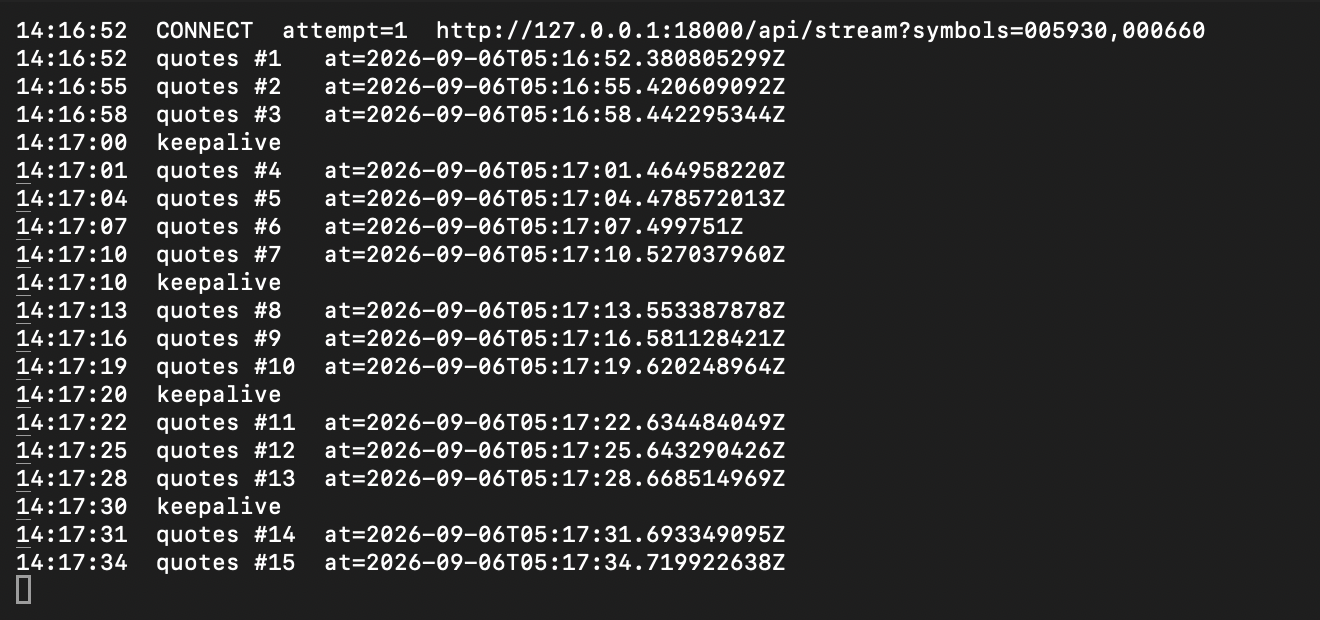
- 전환 시각 14:17:07 앞뒤로
quotes#6과 #7이 이어지고 재접속 기록 없음
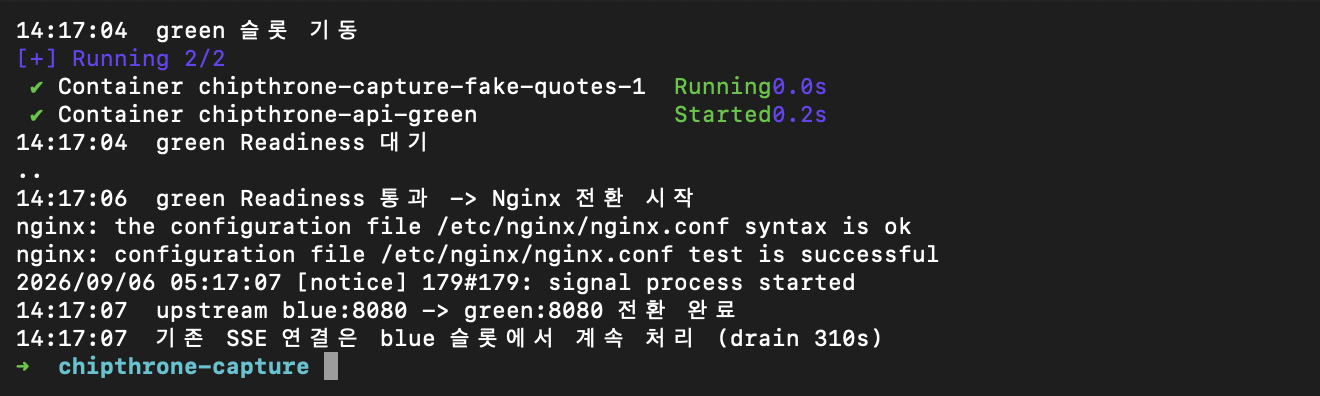
- green 기동 후 Readiness와
nginx -t통과 뒤 upstream 변경, 기존 연결을 처리하는 blue는 유지
실패 복구
| 상황 | 재현 | 확인 결과 |
|---|---|---|
| 새 버전 기동 실패 | 기동 제한 시간을 1초로 축소 | 2.5초 안에 새 버전 컨테이너 제거, 외부 헬스체크는 모든 요청에서 200 유지 |
| 같은 이미지 배포 반복 | 실패 image ID 재배포 | 새 버전 컨테이너를 다시 띄우지 않고 0.8초 안에 중단 |
| 전환 직후 무응답 | 새 버전 컨테이너 일시 정지 | 15초 안에 기존 버전으로 롤백, 외부 헬스체크는 16.5초 뒤 200 복구 |
한계
- 자동 롤백은 기존 버전 컨테이너를 보존하는 310초 동안만 지원
- 전환 뒤 갑자기 장애가 발생하면 롤백 전 일부 요청이 실패하므로 자동 롤백이 무중단을 보장하지는 않음