무중단 배포 중 메모리 부족 문제 해결
문제
- blue-green 배포는 기존 버전을 둔 채 새 버전을 띄워 전환하므로, 배포 때마다 두 슬롯의 JVM 두 개가 최대 310초 동안 함께 실행
- 운영 서버는 메모리 916MiB인 t3.micro이고 EC2 기본 설정대로 swap은 두지 않음
- blue-green을 처음 적용할 때는 테스트 요청만 있는데도, 두 JVM이 함께 떠 있는 동안 남은 메모리가 100MiB까지 감소
재현
측정 환경
- EC2의 가용 메모리, 슬롯별 메모리, OOM kill 횟수를 1초 간격으로 수집해 Grafana로 확인
- 로컬에서 Python 부하 스크립트로 SSE 400개를 유지하고 브라우저처럼 끊기면 3초 뒤 다시 연결
- 같은 부하 생성기가 1초마다 외부
/api/health를 2초 제한으로 호출 - 운영과 같은 배포 스크립트로 같은 이미지를 반대 슬롯에 강제 배포해 blue-green 전환 재현
1차: 기존 설정
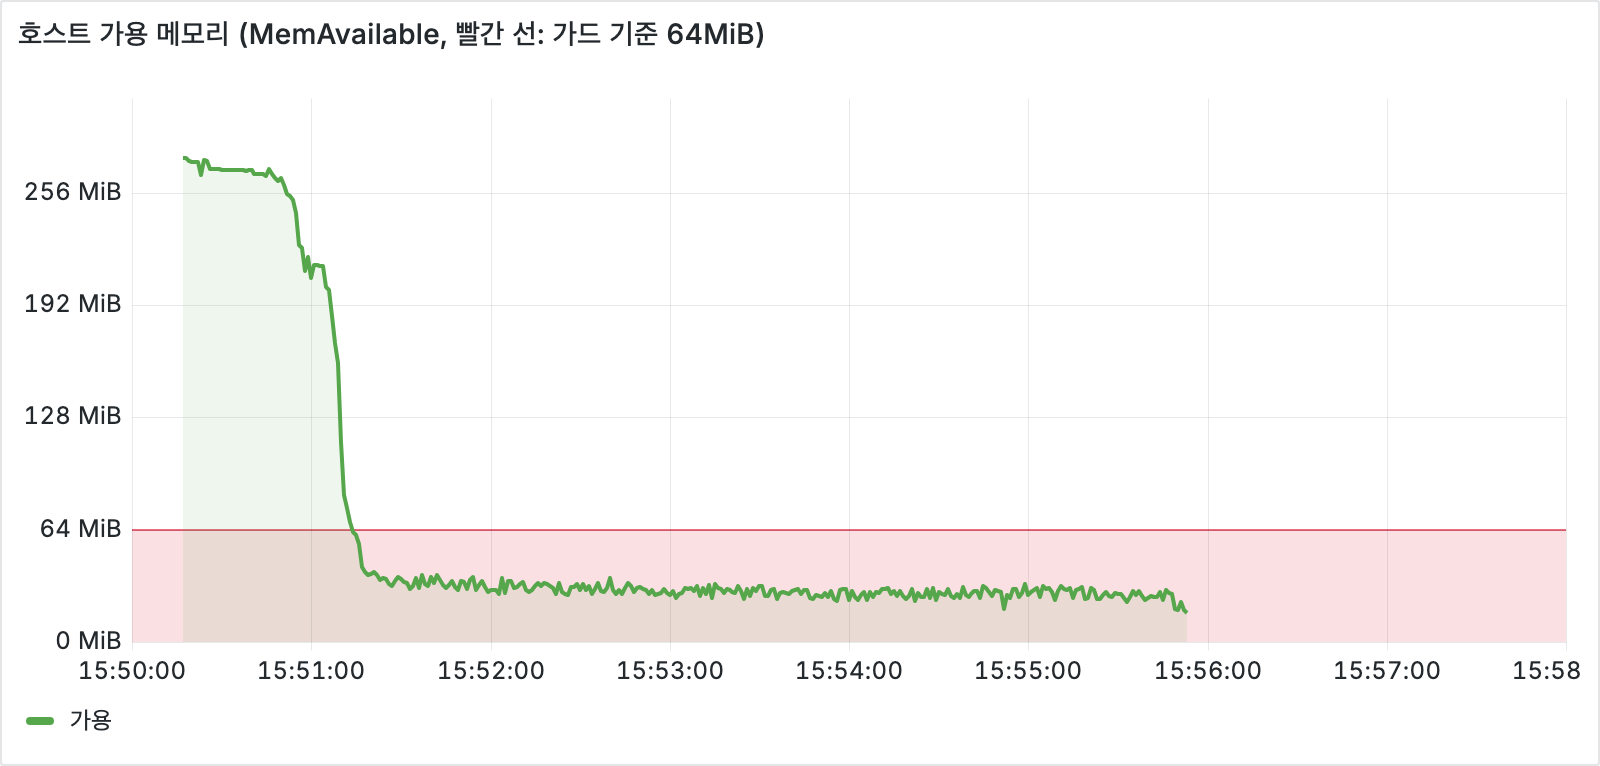
| 시각 | 상황 | 가용 메모리 |
|---|---|---|
| 15:51:00 | 배포 직전 (blue가 SSE 400개 처리) | 208MiB |
| 15:51:20 | green 기동 중 | 39MiB |
| 15:51:3x | green으로 전환, 기존 연결 종료 대기(drain) 시작 | 25~37MiB |
| 15:55:45 | blue SSE가 300초 수명으로 만료되어 green으로 재연결 | 25MiB |
| 15:55:54 | 외부 Health Check 실패 시작, SSH 접속 불가 | 수집 중단 |
| 16:56:39 | 커널 OOM killer가 blue java를 강제 종료해 서버 응답 복구 | - |
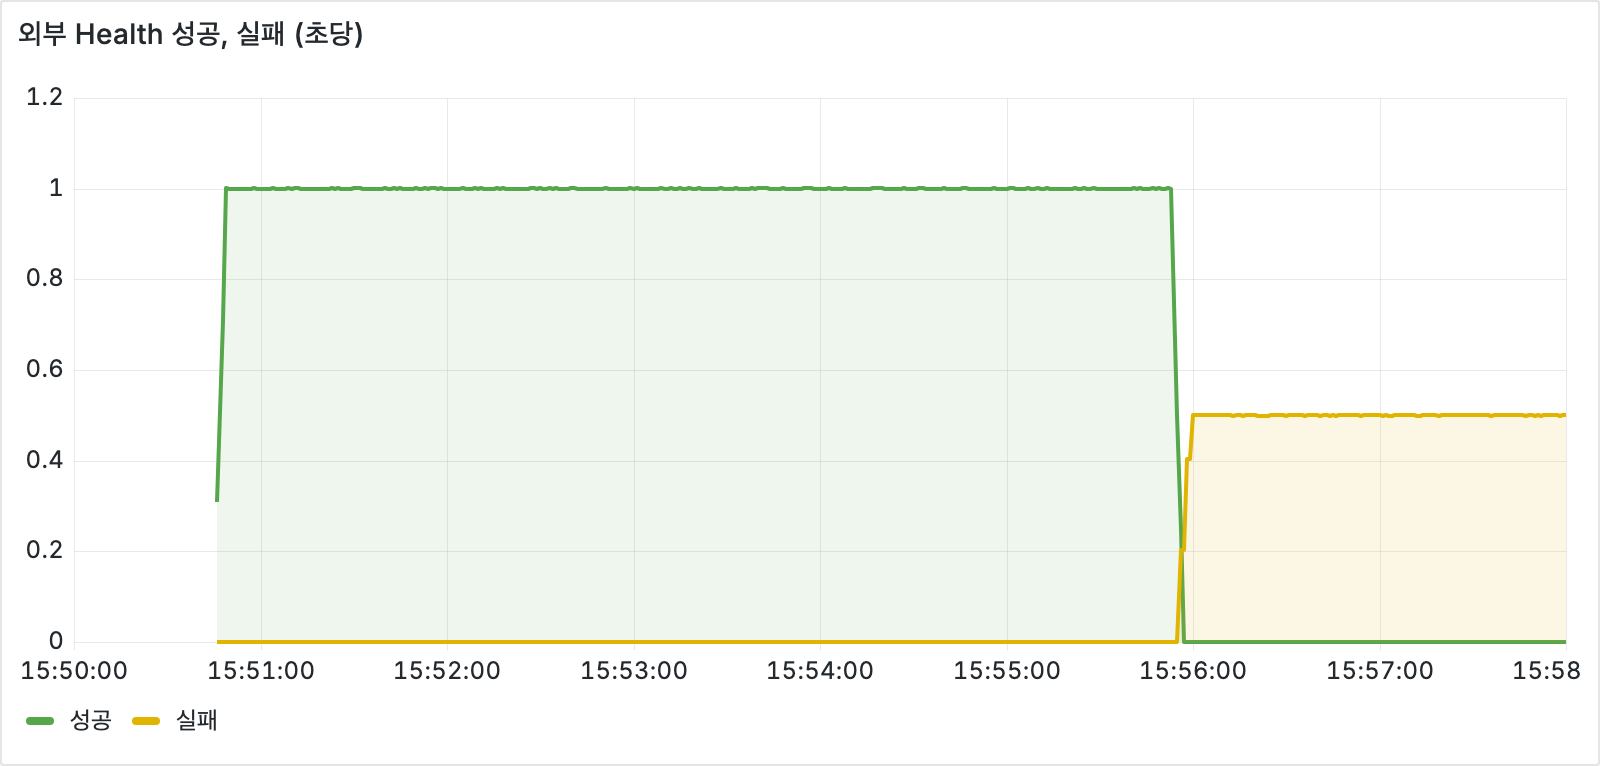
- 15:55:54부터 외부 Health Check가 모두 실패
- 같은 시간 EC2 상태 검사는 모두 통과, AWS 입장에서 인스턴스는 정상
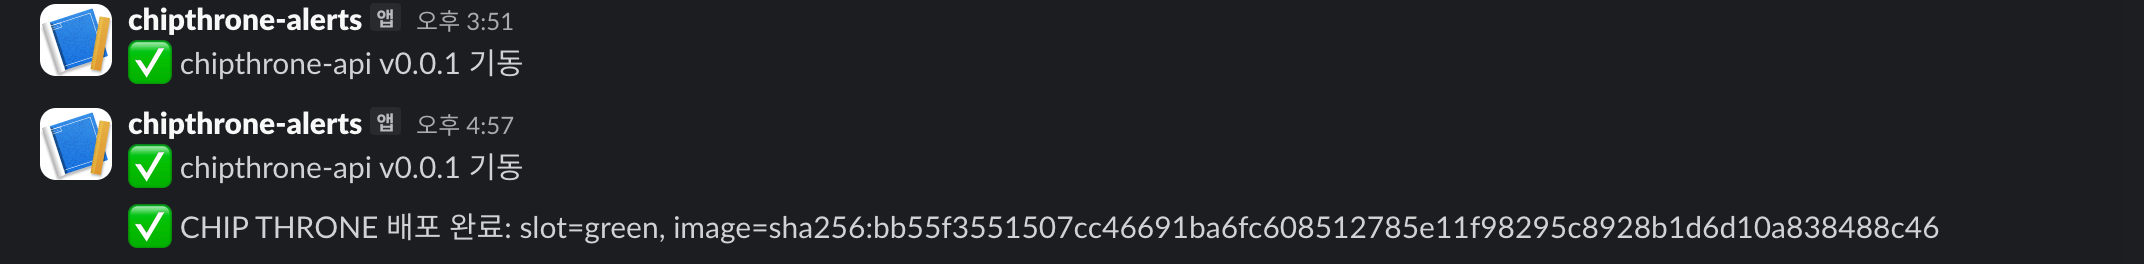
- 15:51 새 슬롯 기동 알림 이후 장애 알림 없이 66분이 지나고 16:57에 배포 완료만 전송
- 배포 스크립트는 OOM kill 이후 남은 확인이 통과하자
deployment completed로 종료. 61분 장애가 성공 배포로 기록됨
원인 분석
OOM killer는 왜 61분 뒤에 동작했나
            pgpgin/s  majflt/s  pgscank/s  %vmeff  ldavg-1  kbcached
15:40:04       91.89      0.70      42.22  145.20     0.01    317880
16:56:39   120282.40   1048.46 2235759.68    1.48    84.43    109688
- 서버의 sysstat 기록으로, 윗줄은 평소 값이고 아랫줄은 장애 구간의 평균
- 커널은 실행 코드만 버렸다가 다시 읽기를 반복함. major fault가 초당 0.7회에서 1,048회로 증가
- 회수가 조금씩은 진행되니 커널은 OOM으로 판단하지 않았고 그동안 서버 전체가 멈춤
16:56:39 kernel: VM Periodic Tas invoked oom-killer
16:56:43 kernel: Out of memory: Killed process 3304206 (java) anon-rss:317552kB
- 61분이 지난 16:56:39, JVM 내부 스레드가 메모리를 요청하다 결국 OOM killer를 호출
- 커널이 약 310MiB를 쓰던 기존 blue 슬롯의 java를 강제 종료하자 메모리가 풀리며 서버 응답 복구
새 슬롯 기동만으로 가용 메모리가 바닥난 이유
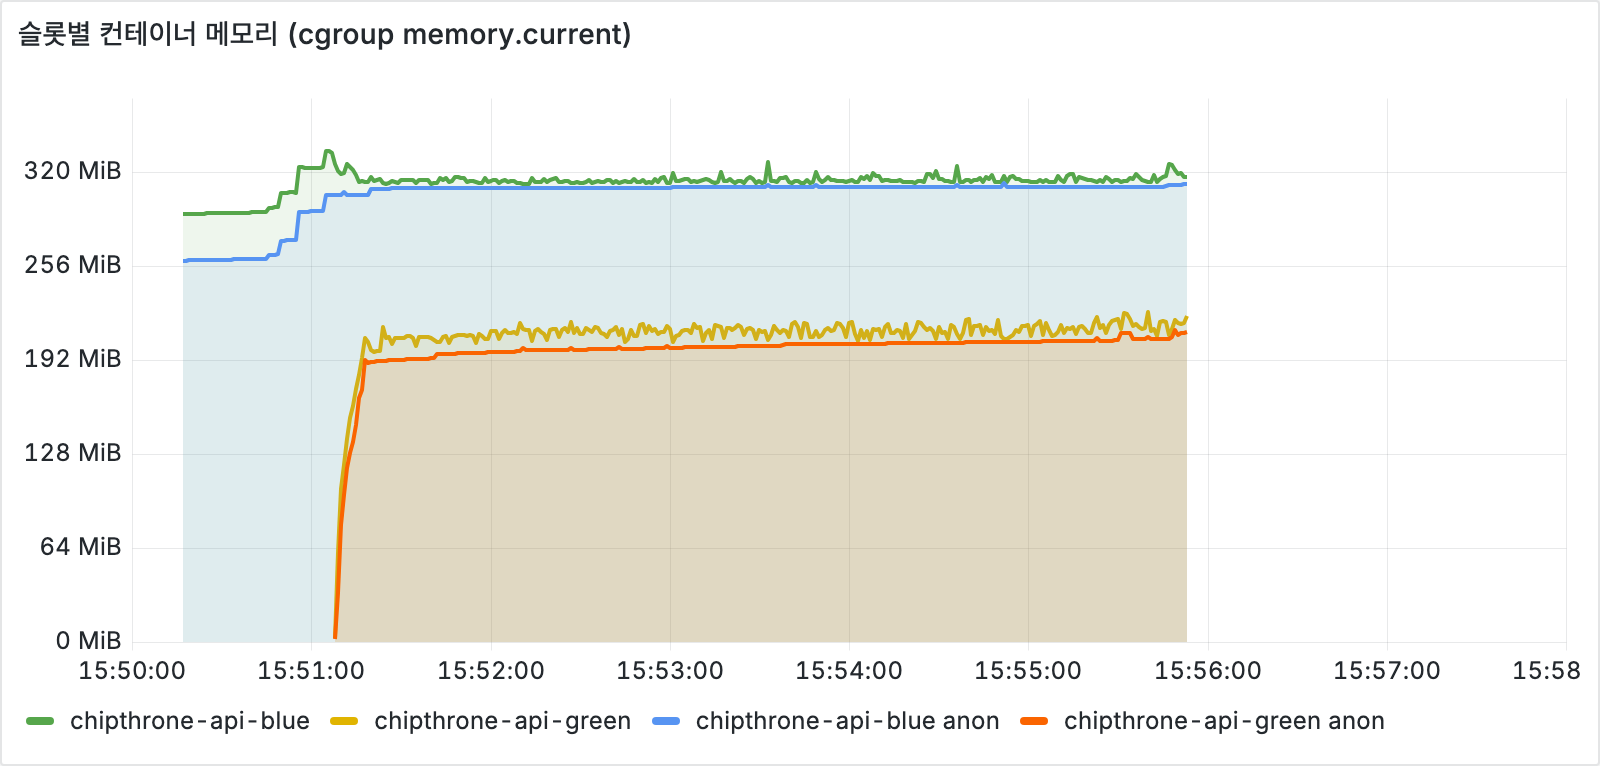
- 두 슬롯이 함께 떠 있는 동안 blue가 약 310MiB, green이 약 210MiB 사용
Native Memory Tracking으로 SSE 400개 상태의 슬롯 하나를 영역별로 나눠 보니 RSS 275MiB 중 heap은 128MiB
| 영역 | committed |
|---|---|
| Java Heap | 128MiB |
| Metaspace와 클래스 영역 | 66MiB |
| Code cache | 28MiB |
| Symbol | 17MiB |
| JIT 컴파일러 arena (최대) | 36MiB |
| 프로세스 RSS | 275MiB |
-Xms128m때문에 heap은 실제 사용량과 관계없이 128MiB 아래로 줄지 않음- 기동 직후 C2 컴파일이 몰리며 컴파일러 arena가 36MiB까지 증가하고 해제 뒤에도 glibc가 돌려주지 않은 만큼 RSS에 남음
- 기존 슬롯이 이미 300MiB를 쓰는 상태에서 새 슬롯의 기동 비용이 겹쳐 가용 메모리가 208MiB에서 39MiB로 하락
기술 선택 이유
-
인스턴스 업그레이드 - 제외
- 메모리가 두 배가 되지만 비용도 두 배. 배포 순간 몇 분을 위해 상시 비용을 늘리는 셈
-
swap 추가 - 제외
- 멈춤이 느려짐으로 바뀔 뿐 두 JVM이 들어가지 않는 원인은 그대로
- GC가 swap된 heap을 훑으면 응답 지연을 예측할 수 없음
-
컨테이너 메모리 제한 - 제외
- 호스트 대신 컨테이너가 OOM kill되지만 제한에 먼저 닿는 쪽은 재연결이 몰리는 새 슬롯
- 새 슬롯이 죽고 재시작하는 반복이 생김
-
JVM 메모리 축소와 배포 스크립트 메모리 가드 - 채택
- 인스턴스를 바꾸지 않고 JVM 메모리를 줄여, 평소 배포는 두 JVM이 겹쳐도 메모리 여유가 남음
- 그래도 가용 메모리가 64MiB 아래로 떨어지면 기존 슬롯을 즉시 내려, 서버가 멈추는 대신 SSE 재연결로 끝남
구현
JVM 메모리 축소
-Xms64m -Xmx320m -XX:TieredStopAtLevel=1 -XX:ReservedCodeCacheSize=32m -Xss512k
| 항목 | 기존 | 조정 후 |
|---|---|---|
| RSS (SSE 400개) | 275MiB | 226MiB |
| 새 슬롯 기동 직후 최대 | 약 210MiB | 174MiB |
| 새 슬롯 Ready까지 | 약 30초 | 7초 |
| CPU 사용 (코어) | 0.046 | 0.038 |
| SSE 전달 지연 p95 | 57ms | 61ms |
- C2 컴파일러를 끄면 처리 성능이 떨어질 수 있어 같은 부하에서 CPU와 전달 지연을 비교
- 3초마다 작은 JSON을 나눠 보내는 I/O 중심 서비스라 차이는 측정 오차 수준
메모리 가드
memory_low() {
  (( $(available_mib) < MIN_AVAILABLE_MIB ))  # 64MiB
}

# drain 중 2초마다 새 슬롯 Readiness와 함께 확인
if [[ -n "$active_name" ]] && memory_low && container_exists "$active_name"; then
  stop_previous_early   # 이전 슬롯 즉시 제거, Slack 알림
fi
- 기준값 64MiB: 1차에서 서버가 멈추기 시작한 18~25MiB에 여유를 둔 값
- 기동 전: 새 슬롯이 쓸 180MiB를 빼고도 64MiB가 남지 않으면 배포 보류
- 기동 중: 64MiB 아래로 내려가면 새 슬롯을 지우고 기존 슬롯 유지. 실패 이미지로 기록하지 않아 다음 주기에 다시 시도
- drain 중: 64MiB 아래로 내려가면 이전 슬롯을 graceful stop 없이 즉시 제거. 1차에서 18MiB에 닿은 뒤 몇 초 만에 멈췄기 때문
- 세 경로를 배포 스크립트 자동 테스트에 추가
검증
1차와 같은 조건(SSE 400개, 같은 이미지 강제 배포, drain 310초)으로 다시 실행
| 확인 항목 | 1차 | 2차 |
|---|---|---|
| 배포 직전 가용 메모리 | 208MiB | 323MiB |
| 재연결 전 최저 가용 메모리 | 25MiB | 118MiB |
| 외부 Health Check 실패 | 153회 (61분 멈춤) | 0회 |
| Health Check 최대 응답 시간 | 2,001ms (timeout) | 209ms |
| SSE 재연결 | 2,243회 | 400회 |
| OOM kill | 1회 | 0회 |
- 재연결 400회는 가드 때문이 아니라 SSE 최대 연결 시간이 끝나 원래 일어나는 재연결
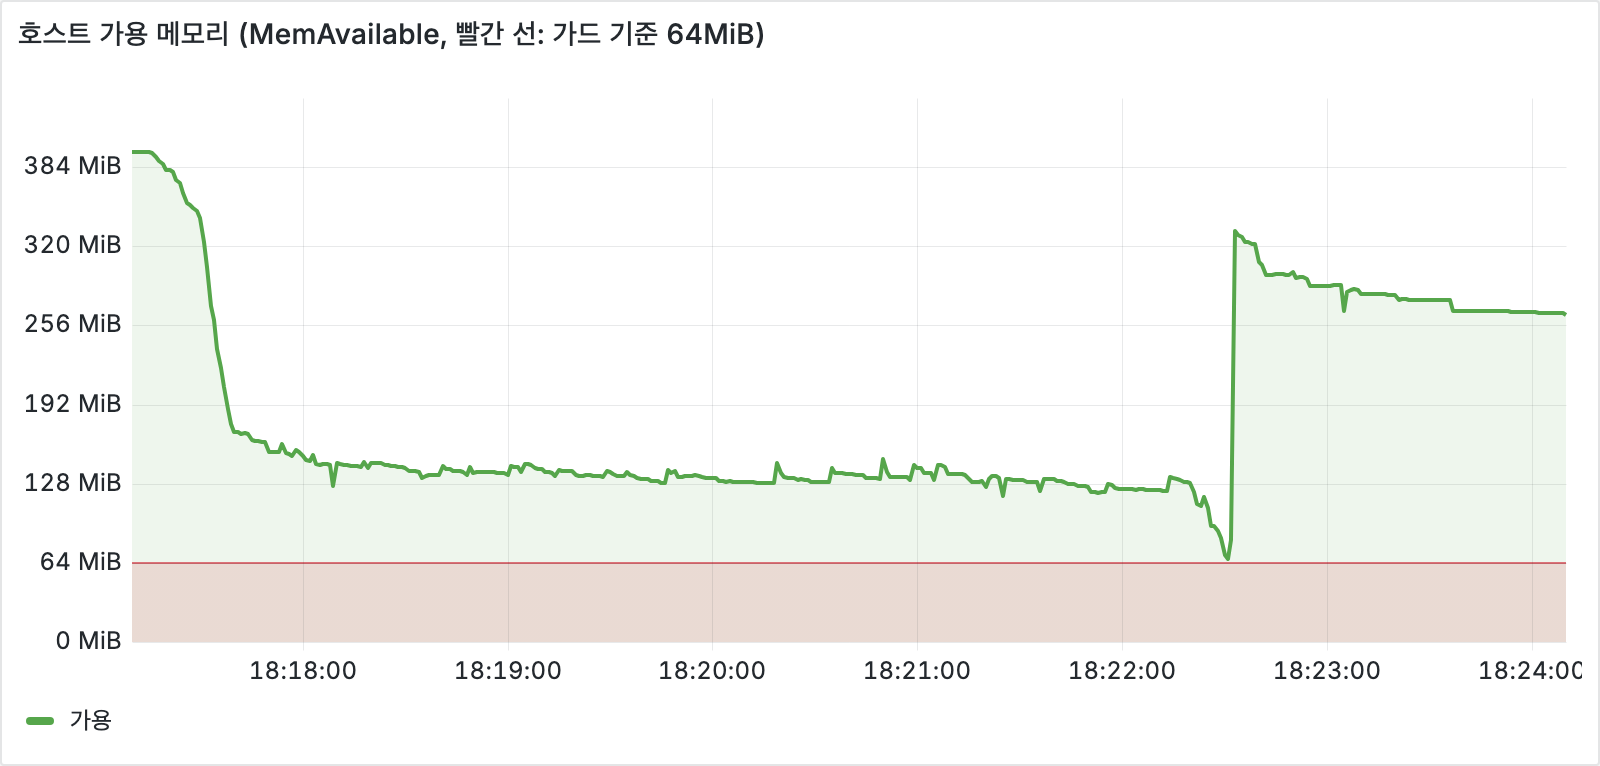
- 전환 뒤에도 가용 메모리가 100MiB 이상 유지
- 18:22:14부터 blue의 SSE 400개가 300초 수명으로 만료되어 green으로 재연결
- 재연결이 끝난 18:22:31, 연결이 0개인 blue가 메모리를 쥐고 있는 동안 가용 메모리가 64MiB 아래로 내려가 가드가 blue 제거
- 원래 drain 종료보다 17초 이른 시점이며 2초 뒤 가용 메모리 332MiB로 회복
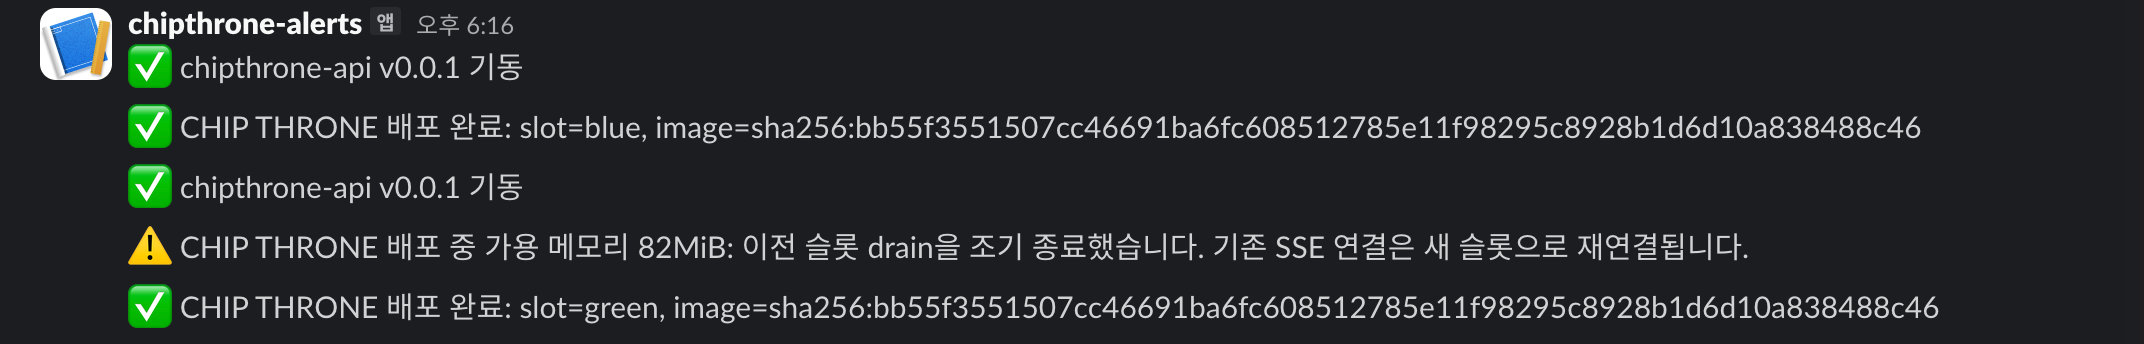
- 가드가 이전 슬롯 drain을 일찍 끝냈다는 경고 뒤 배포 완료 전송
- 알림의 82MiB는 64MiB 미만을 감지한 뒤 이전 슬롯을 제거하기 직전에 다시 읽은 값
한계
- JVM 옵션과 가드를 함께 바꿔 측정했기 때문에, 가드 없이 조정한 JVM만으로도 멈추지 않았을지는 이 실험으로 알 수 없음
- 가드가 drain을 일찍 끝내면 그 배포는 자동 롤백 대상 슬롯이 없음